SCENIC:单细胞转录因子调控
一.SCENIC原理
SCENIC (Single-Cell rEgulatory Network Inference and Clustering)是在单细胞基因表达谱上预测转录因子调控网络并进行打分的工具。SCENIC在17年发表在Nature Method [1] 上,19年加了Python版本并更新下分析流程,发表了一篇Nature Protocol [2]。
SCENIC的整个计算中有三个关键步骤:
- 识别每个转录因子的靶基因
- 在上一步的结果中根据DNA-motifs选择直接结合的靶基因
- 计算网络活性得分
在开始之前,先说一下SCENIC的输入和输出吧,便于对每个步骤的理解。输入是一个行是基因,列是细胞的表达谱,结合转录因子(TF)和DNA-motif信息,最后得到一个行是转录因子,列是细胞的活性得分矩阵。
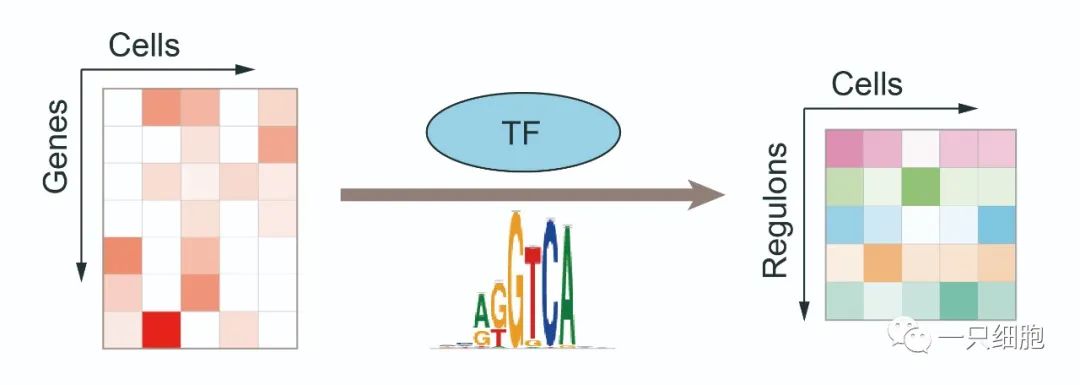
1. 识别转录因子的靶基因
这一步使用GENIE3 [3] 或GRNBoost2 [4] 得到转录因子的靶基因。这两个R包的原理是一样的,SCENIC默认会使用GENIE3。
GENEI3是基于共表达的思想得到每个转录因子共表达的靶基因集。那么怎么去定义两个基因是共表达的呢?如果一个基因的表达能够预测另一个基因的表达,那我们是不是就可以说这两个基因是共表达的了。在整个基因组中,能预测一个转录因子表达的肯定不是一个基因,是一群基因。怎么在2万个基因中找到能够更好预测某个转录因子表达的基因集呢?很像一个特征选择的问题对不对!所以,GENEI3就用随机森林对于每个转录因子都建立了一片森林,用剩下的所有基因表达去预测这个转录因子的表达,在预测过程中找到权重比较大的基因集,就是这个转录因子的靶基因集了。
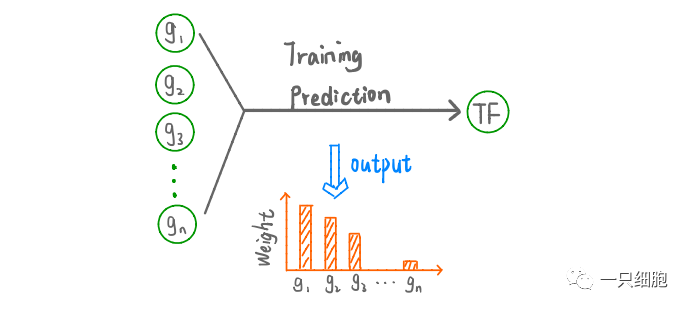
在实际的使用中,SCENIC使用一系列的阈值来定义某个关系对是激活,抑制或者无调控 [1]
有一点是SCENIC只会留下激活的调控关系对。某个转录因子的靶基因如果少于20,在下游的分析中也会被过滤掉(因为不稳定)。
2. 根据DNA-motifs选择直接结合的靶基因
上一步的结果只是基于共表达,所以会包含直接或间接和转录因子结合的基因,这一步就是要找到那些直接互作的基因集。这一步用到一个叫RisTarget的R包,整体的假设是被某一个转录因子结合的不同基因都会有一段类似的结合区域(binding site)。通过比较真正互作的基因集和基因组剩下基因的分值,得到潜在可能有真正结合的区域,及其对应到的基因。两步走:
- 对于每个motif来说,对所有基因进行打分,排在最上面的基因就是最可能的靶基因。
- 对于某个特定基因集,通过计算其曲线下面积(AUC) 来得到这个基因集是不是和某个motif是显著相关的。
这个AUC在下一步会重点说,现在只需要知道它的作用就是,如果基因集中的基因在整个基因组的排序中更靠前,那么这个基因集的得分会更高。另外,因为基因是经过排序的,可以通过一定的策略只留下排名更靠前的基因。
关于每个物种的DNA-motifs包含三个数据库:转录起始位点上游500bp,转录因子上下游5kb,转录因子上下游10kb。因为转录本很多,每个基因会有很多motif,这个时候用排名最高的motif对应的排名作为基因的排名。
3. 计算网络活性得分
经过前两步的计算和过滤,我们得到了每个转录因子对应的靶基因及其调控关系。虽然最后结果叫做基因调控网络,但是在这一步计算网络活性得分的时候可以完全把这个网络看作一个基因集。这个活性得分用到一个叫AUCell的方法,这个方法顾名思义,是我们上一步提到的AUC的概念。不同的是这次排序是将每个细胞的所有基因根据其基因表达进行排序。这个算法是一个细胞一个基因集算一个分值,比如说我们有一个细胞,它有8个基因。然后有一个基因集包含3个基因,分别对应到排序为1,5,7三个基因,那么这个基因集在这个细胞中的打分就是橙色面积除以蓝色面积(图左)。
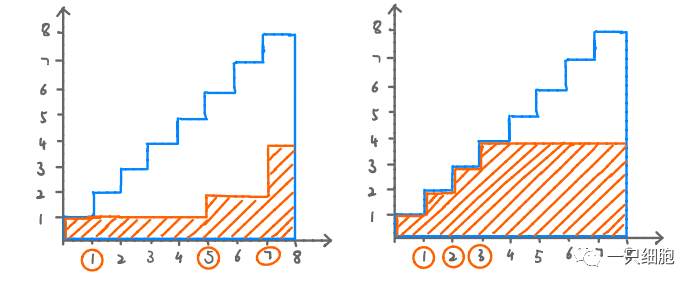
这两个面积怎么画出来的呢?
可以想象我们是一只蚂蚁,从坐标为(0,1)的点开始走,一步一个单位。
一开始往右走,遇见一个横坐标就往上走一步,直到走到(8,8),这个时候走过的路线和X轴围成的面积就是图中的蓝色面积。
回到(0,1),还是一开始往右走,这次我们高冷一点,直到遇到被标注的横坐标(基因集中的基因)再往上走一步,这个时候走完全程的路线和X轴围成的面积就是图中的橙色面积。
那么,为什么被标注的基因排名越靠前,最后的分值就越高呢?如果基因集中的三个基因正好是1,2,3(图右),这个面积很明显比左边大对不对,而且这个组合是数量为3的基因集的最大分值。
参考文献:
[1] Aibar, S., González-Blas, C., Moerman, T. et al. SCENIC: single-cell regulatory network inference and clustering. Nat Methods 14, 1083–1086 (2017).
[2] Van de Sande, B., Flerin, C., Davie, K. et al. A scalable SCENIC workflow for single-cell gene regulatory network analysis. Nat Protoc 15, 2247–2276 (2020).
[3] Huynh-Thu, V., Irrthum, A., Wehenkel, L. & Geurts, P. Inferring regulatory networks from expression data using tree-based methods. PLoS ONE 5, e12776 (2010).
[4] Moerman, T. et al. GRNBoost2 and Arboreto: efficient and scalable inference of gene regulatory networks. Bioinformatics 35, 2159–2161 (2018).
二.安装SCENIC和调配环境设置
1.设置一个Python环境
以下示例命令应在Unix shell(即bash或类似程序)中运行以设置软件。在Conda环境中,建议使用如下:
2 安装必要和可选的Python软件包,并配置Jupyter(Lab)服务器的用法。
安装 scanpy (https://scanpy.readthedocs.io/en/latest/installation.html))
conda install seaborn scikit-learn statsmodels numba pytables
conda install -c conda-forge python-igraph louvain
conda install -c conda-forge multicore-tsne
pip install scanpy
# Install pySCENIC
pip install pyscenic
# Install environment as kernel for Jupyter
pip install --user ipykernel
python -m ipykernel install --user --name=scenic_protocol

pip install loompy
3.下载辅助文件
TF列表,排名数据库和主题注释(在此示例中为人类):
# transcription factors:
curl https://raw.githubusercontent.com/aertslab/pySCENIC/master/resources/hs_hgnc_tfs.txt
# motif to TF annotation database:
curl https://resources.aertslab.org/cistarget/motif2tf/motifs-v9-nr.hgnc-m0.001-o0.0.tbl
4.数据预处理
下载用于案例研究的表达矩阵(来自10x Genomics的PBMC 10k数据集)。在下面的部分中,使用wget Linux实用程序从命令行获取数据集:
curl http://cf.10xgenomics.com/samples/cell-exp/3.0.0/pbmc_10k_v3/pbmc_10k_v3_filtered_feature_bc_matrix.tar.gz
tar xvf pbmc_10k_v3_filtered_feature_bc_matrix.tar.gz
对下载的表达数据集执行清洁和质量控制。在此示例中,我们使用Scanpy包(https://scanpy.readthedocs.io/en/latest/)
启动Python
import scanpy as sc
import numpy as np
adata = sc.read_10x_mtx("filtered_feature_bc_matrix/",var_names = 'gene_symbols')
adata.var_names_make_unique()
# compute the number of genes per cell (computes ‘n_genes' column)
sc.pp.filter_cells(adata, min_genes=0)
# mito and genes/counts cuts
mito_genes = adata.var_names.str.startswith('MT-')
# for each cell compute fraction of counts in mito genes vs. all genes

adata.obs['percent_mito'] = np.ravel(np.sum(adata[:, mito_genes].X, axis=1)) / np.ravel(np.sum(adata.X, axis=1))
# add the total counts per cell as observations-annotation to adata
adata.obs['n_counts'] = np.ravel(adata.X.sum(axis=1))
5.使用基本阈值进行基因和细胞的过滤步骤:
sc.pp.filter_cells(adata, min_genes=200)
sc.pp.filter_genes(adata, min_cells=3)
adata = adata[adata.obs['n_genes'] < 4000, :]
adata = adata[adata.obs['percent_mito'] < 0.15, :]
6.使用过滤后的数据创建一个loom文件,以用于下游分析:
import loompy as lp
row_attrs = {"Gene": np.array(adata.var_names),}
col_attrs = {
"CellID": np.array(adata.obs_names),
"nGene": np.array(np.sum(adata.X.transpose()>0, axis=0)).flatten(),
"nUMI": np.array(np.sum(adata.X.transpose(),axis=0)).flatten(),
}
lp.create("PBMC10k_filtered.loom",adata.X.transpose(),row_attrs,col_attrs)
从CLI运行GRNBoost2网络推断算法:
## Docker
docker run -it -v $PWD:$PWD aertslab/pyscenic:0.9.18 \
pyscenic grn \
{... }
## Singularity
singularity exec -B $PWD:$PWD aertslab-pyscenic-0.9.18.sif \
pyscenic grn \
{... }
更新: 2022-08-18 14:33:40 原文: https://www.yuque.com/doublehelix/bioinfonotes/dgxp1r