单细胞下游分析
单细胞专题 | 1.单细胞测序(10×genomics技术)的原理
单细胞专题 | 3.单细胞转录组的上游分析-从BCL到FASTQ
单细胞专题 | 4.单细胞转录组的上游分析-从SRA到FASTQ
单细胞专题 | 5.单细胞转录组的上游分析-从FASTQ到count矩阵
1.数据读入
Cell Ranger生成的主要表格文件主要包括3个文件,分别是barcodes, features, matrix三个表格文件,其中barcodes文件存储的是细胞的信息,features存储的是基因的名称信息,matrix存储的是表达量的信息。还有一种数据是作者在GEO数据库直接提供表达矩阵(csv或txt)
(1).读入csv文件的表达矩阵构建Seurat对象
Seurat需要的输入信息为表达量矩阵,矩阵行为基因,列为细胞。使用Seurat提供的Read10X函数可以很方便的将10x结果读入到R矩阵中。使用CreateSeuratObject生成Seurat对象,后续分析都是在该对象上进行操作。
有了表达矩阵,直接使用 CreateSeuratObject 函数即可,然后慢慢添加这个表达矩阵的一些其它外部属性,全部代码如下:
# Create the Seurat object with all the data (unfiltered)
main_tiss <- CreateSeuratObject(counts = raw.data)
# add rownames to metadta
row.names(metadata) <- metadata$cell_id
# add metadata to Seurat object
main_tiss <- AddMetaData(object = main_tiss, metadata = metadata)
main_tiss <- AddMetaData(object = main_tiss, percent.ercc, col.name = "percent.ercc")
# Head to check
head(main_tiss@meta.data)

# Calculate percent ribosomal genes and add to metadata
ribo.genes <- grep(pattern = "^RP[SL][[:digit:]]", x = rownames(x = main_tiss@assays$RNA@data), value = TRUE)
percent.ribo <- Matrix::colSums(main_tiss@assays$RNA@counts[ribo.genes, ])/Matrix::colSums(main_tiss@assays$RNA@data)
fivenum(percent.ribo)
main_tiss <- AddMetaData(object = main_tiss, metadata = percent.ribo, col.name = "percent.ribo")
main_tiss

# Filter cells so that remaining cells have nGenes >= 500 and nReads >= 50000
main_tiss_filtered <- subset(x=main_tiss, subset = nCount_RNA > 50000 & nFeature_RNA > 500)
main_tiss_filtered
我们得到了main_tiss_filtered这个变量,是一个Seurat对象,就可以follow我们的教程后后续分析流程啦。参考代码仍然是:
(2).读入10X标准输出的3个文件和融合多个样本数据
这三个文件指的是:barcodes.tsv, features.tsv, matrix.mtx。这个情况就比较好处理了,barcodes.tsv就是 cell id,features.tsv就是 gene id,matrix.mtx就是计数 counts 矩阵。

例如:
在如:

(3).读入h5格式文件
(4). h5ad格式
需要安装SeuratDisk包,先将后h5ad格式转换为h5seurat格式,再使用LoadH5Seurat()函数读取Seurat对象。
2.数据质控
可参考:https://mp.weixin.qq.com/s/g_tAhFQfr2IhFyHxzcFRTg 质控的目的是去除掉低质量的数据,包括破损或死亡的细胞、没捕获到细胞的empty droplet和捕获到2个以上细胞的doublets。一般低质量的细胞或者empty droplet通常含有很少的基因,而doublets容易测到更多的基因。另一方面,低质量或者死亡细胞会测到更多的线粒体基因表达的RNA。 使用PercentageFeatureSet函数评估每个细胞中的线粒体表达比例:
pattern = "^MT-"表示线粒体基因的匹配模式,人的线粒体基因以MT-为前缀,小鼠的以Mt-为前缀。 Seurat对象在生成时,已经将每个细胞表达的基因数和reads数记录在meta.data的nFeature_RNA和nCount_RNA中。我们使用VlnPlot函数将nFeature_RNA、nCount_RNA和percent.mt三个指标进行可视化。
3.数据标准化
基因的表达矩阵需要经过标准化后才能进行后续的分析。使用NormalizeData函数进行标准化,normalization.method:标准化方法,可选项,
- logNormalize: log(每个细胞的特征counts/细胞count总数*scale.factor)
- CLR:中心化对数标准化
- RC:相对计数,计算公式同logNormalize,不取log,计算CPM表达量,设置scale.factor=1e6
可选择LogNormalize:
4.细胞周期分析
A cell cycle is a series of events that takes place in a cell as it grows and divides.即描述细胞生长、分裂整个过程中细胞变化过程。最重要的两个特点就是DNA复制、分裂成两个一样的子细胞。 如下图,一般分成4个阶段
- G1(gap1):Cell increases in size(Cellular contents duplicated)
- S(synthesis) :DNA replication, each of the 46 chromosomes (23 pairs) is replicated by the cell
- G2(gap2):Cell grows more,organelles and proteins develop in preparation for cell division,为分裂做准备
- M(mitosis):'Old' cell partitions the two copies of the genetic material into the two daughter cells. And the cell cycle can begin again.

在分析单细胞数据时,同一类型的细胞往往来自于不同的细胞周期阶段,这可能对下游聚类分析,细胞类型注释产生混淆;由于细胞周期也是通过cell cycle related protein 调控,即每个阶段有显著的marker基因;通过分析细胞周期有关基因的表达情况,可以对细胞所处周期阶段进行注释; 在单细胞周期分析时,通常只考虑三个阶段:G1、S、G2M。(即把G2和M当做一个phase) 主要学习两种来自scran与Seurat包鉴定细胞周期的方法介绍与演示。
(1).Seurat包
Seurat包CellCycleScoring较scran包cyclone函数最主要的区别是直接根据每个cycle,一组marker基因表达值判断。

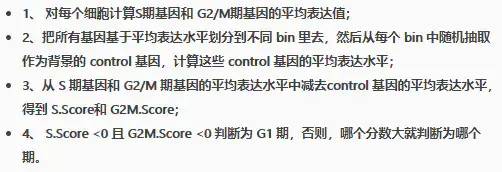
如上是Seurat包提供的人的细胞中分别与S期、G2M期直接相关的marker基因。 CellCycleScoring即根据此,对每个细胞的S期、G2M期可能性进行打分;具体如何计算的,暂时在Seurat官方文档中没有提及。在satijalab的github(https://github.com/satijalab/seurat/issues/728))中,作者这样回复类似的提问: As we say in the vignette, the scores are computed using an algorithm developed by Itay Tirosh, when he was a postdoc in the Regev Lab (Science et al., 2016). The gene sets are also taken from his work. You can read the methods section of https://www.ncbi.nlm.nih.gov/pmc/articles/PMC4944528/ to see how the scoring works, but essentially the method scores cells based on the expression of each gene in a signature set - after controlling for the expected expression of genes with similar abundance. 结合一些中文教程(https://www.jianshu.com/p/e4a5b5c67de1)的介绍,认为就是根据每个细胞的S期(或者G2/M期)基因集是否显著高表达,对应的score就是表示在该细胞中,S期(或者G2/M期)基因集高表达的程度(如果是负数,就认为不属于该phase)。
区别于scran包的另外重要的一点就是Seurat包仅提供了人类细胞有关的cell cycle related gene,没有小鼠的。对此,作者这样回复:Thanks. We don't provide different capitalizations because this gene list was developed on a human dataset, and we don't want to create ambiguity by suggesting its created from a mouse reference dataset. **In practice however, we've found it works quite well for mouse also, and recommend the solution above.** 简言之,作者认为可以将对应人的cc.gene转换为鼠对应的基因名,当做后者的cell cycle related gene(因为鼠和人类基因的高度相似性)。提到的solution就是采用biomaRt包转换一下。这在我之前的教程中有介绍。
但是biomaRt包网络不是很稳定,有人也直接提供了转换后的结果(https://github.com/satijalab/seurat/issues/462),直接下载导入到R里即可,下面演示的代码就是用的该结果。

(2).scran包
http://bioconductor.org/packages/release/bioc/manuals/scran/man/scran.pdf scran包cyclone函数是利用‘marker基因对’表达来对细胞所在周期阶段进行预测的方法Scialdone (2015) “maker基因对”由作者根据训练集细胞(已注释了cell cycle)的基因表达特征产生,我们可以直接使用。对于每一细胞周期阶段(人/鼠)都有一组“maker基因对”集合。

如上图,具体来说,即比较某个细胞的ENSMUSG00000000001基因表达值是否大于ENSMUSG00000001785基因表达值。 如果对于所有G1期marker基因对,某个细胞的“first”列基因表达量大于对应的“second”基因的情况越多,则越有把握认为该细胞就是处于G1期(因为越符合训练集特征)。 而cyclone则是通过计算score,即对于某个细胞,符合上述比较关系的marker基因对数占全部marker基因对数的比值。 这里默认提供marker基因对是ensemble格式,如果表达数据提供的是其它类类型的基因ID,比如:SYMBOL,那么我们需要转化一下ID。
下面是计算三个周期阶段的scores:

根据每一个细胞对于三个周期阶段的scores,可进行判断;具体规则为 G1或G2M评分高于0.5的细胞分别被分配到G1期或G2M期。若G1 or G2M phases均小于0.5,则可判断为S期(虽然可以直接看S期的score);若G1 or G2M phases均大于0.5,则 the higher score is used for assignment。
5.检测doublets
6.单细胞多样本整合
CCA和RPCA整合方法都是Seurat包内置并推荐使用的。区别在于: CCA 方法非常适合在细胞类型保守的情况下识别锚点,但在不同实验处理下基因表达存在非常大的差异,
- 简而言之,CCA适合多个样本具有大致相似的细胞类型分布,也适合跨物种的多样本整合。
- 值得注意的是,CCA方法可能会导致整合过度,即可能会消除多样本间的生物学差异;
而RPCA方法的整合运行速度更快,整合的力度较CCA弱一些(更保守),
- 适合多个样本有不同的细胞类型分布情况;
- 建议多样本数据均是来自同一个平台的,例如要整合的目的样本均来自10X测序平台;
- 如大样本量的单细胞数据集整合。
FindIntegrationAnchors函数中的reduction参数进行设置: Dimensional reduction to perform when finding anchors. Can be one of:
- cca: Canonical correlation analysis
- rpca: Reciprocal PCA
- rlsi: Reciprocal LSI
整合前后:

7.聚类


8.细胞类型注释


