TCGAbiolinks包-老版本
肿瘤基因组图谱(TCGA)计划是由美国National Cancer Institute(NCI)和National Human Genome Research Institute(NHGRI)于2006年联合启动的项目,研究的癌症类型从最开始的多形性成胶质细胞瘤(GBM)到现在为止共有39种,涉及29种癌症器官,1万多个肿瘤样本,27万多份文件,当然其项目也将于2017年接近尾声。
网址:https://portal.gdc.cancer.gov/
对于肿瘤研究者来说,TCGA数据库就是一个资源宝库,里面有很多有价值的信息可以挖掘,关于TCGA数据挖掘的工具很多,包括在线工具和R包。这里我们主要是通过R语言进行挖掘,所以需要有一点R语言基础。R语言快速入门可参考文章:R语言编程基础第一篇:语法基础。也可以自己找教程自学,网上教程很多,学习了R以后,我们就的真正的去了解TCGA数据库,我们之前的文章:TCGA数据库使用教程对该数据库进行了详细的介绍,不了解该数据库的同学可以先了解网页版的使用。
使用R语言挖掘TCGA数据,可以用的包很多,比如GDCRNATools包,以及之前我们介绍过的TCGA-Assembler包。在这里我们就不推荐使用这些包,我们只推荐本文要介绍的TCGAbiolinks包。这个包的功能很强大,学会了这个包几乎就已经够用,不用在学其他包。今天我们开始
tcgabiollinks提供了一些搜索GDC数据库的功能。本节首先解释了不同的GDC资源(Harmonized和Legacy Archive),然后是一些如何访问它们的例子。
TCGA条形码由一组标识符组成。每个都明确地标识一个TCGA数据元素。有关元数据标识符如何组成条形码的说明,请参阅下图。分隔符条码包含最多的标识符。
以下是使用tcgabiolink下载GDC数据的两个可用来源:
GDC Legacy Archive : 提供访问以前存储在CGHub和TCGA数据门户(由TCGA数据协调中心(DCC)托管)的未经修改的数据副本,在TCGA数据协调中心(DCC)使用参考GRCh37 (hg19)和GRCh36 (hg18)。
GDC harmonized database:可利用的数据与GRCh38 (hg38)使用GDC生物信息学管道进行协调,该管道为生物标本和临床数据的标准化提供了方法。
1)对于legacy数据(与hg19对齐的数据),TCGAbiolinks正在使用GRCh37.p13进行注释;
2)对于harmonized数据(与hg38对齐的数据),TCGAbiolinks正在使用GRCh38.p7 (May 2017)进行注释。
一.TCGAbiolinks包
1.GDCquery()函数
GDCquery(
  project,
  data.category,
  data.type,
  workflow.type,
  legacy = FALSE,
  access,
  platform,
  file.type,
  barcode,
  data.format,
  experimental.strategy,
  sample.type
)
(1)project
有效项目的列表可通过getGDCprojects()$project_id查看。
> getGDCprojects()$project_id
 [1] "GENIE-MSK"             "TCGA-UCEC"             "TCGA-LGG"
 [4] "TCGA-SARC"             "TCGA-PAAD"             "TCGA-ESCA"
 [7] "TCGA-PRAD"             "GENIE-VICC"            "TCGA-LAML"
[10] "TCGA-KIRC"             "TCGA-PCPG"             "TCGA-HNSC"
[13] "GENIE-JHU"             "TCGA-OV"               "TCGA-GBM"
[16] "TCGA-UCS"              "TCGA-MESO"             "TCGA-TGCT"
[19] "TCGA-KICH"             "TCGA-READ"             "TCGA-UVM"
[22] "TCGA-THCA"             "OHSU-CNL"              "GENIE-DFCI"
[25] "GENIE-NKI"             "GENIE-GRCC"            "FM-AD"
[28] "GENIE-UHN"             "GENIE-MDA"             "TCGA-LIHC"
[31] "TCGA-THYM"             "TCGA-CHOL"             "TARGET-ALL-P1"
[34] "ORGANOID-PANCREATIC"   "TCGA-DLBC"             "TCGA-KIRP"
[37] "TCGA-BLCA"             "TARGET-ALL-P3"         "TARGET-CCSK"
[40] "TARGET-NBL"            "TARGET-AML"            "TARGET-ALL-P2"
[43] "NCICCR-DLBCL"          "CTSP-DLBCL1"           "TARGET-RT"
[46] "TARGET-OS"             "TCGA-BRCA"             "TCGA-COAD"
[49] "TCGA-CESC"             "TCGA-LUSC"             "TCGA-STAD"
[52] "TCGA-SKCM"             "TCGA-LUAD"             "TARGET-WT"
[55] "TCGA-ACC"              "BEATAML1.0-CRENOLANIB" "BEATAML1.0-COHORT"
[58] "VAREPOP-APOLLO"        "MMRF-COMMPASS"         "WCDT-MCRPC"
[61] "CGCI-HTMCP-CC"         "CMI-ASC"               "CMI-MPC"
[64] "CMI-MBC"               "CPTAC-2"               "CGCI-BLGSP"
[67] "CPTAC-3"               "HCMI-CMDC"
(2)data.category
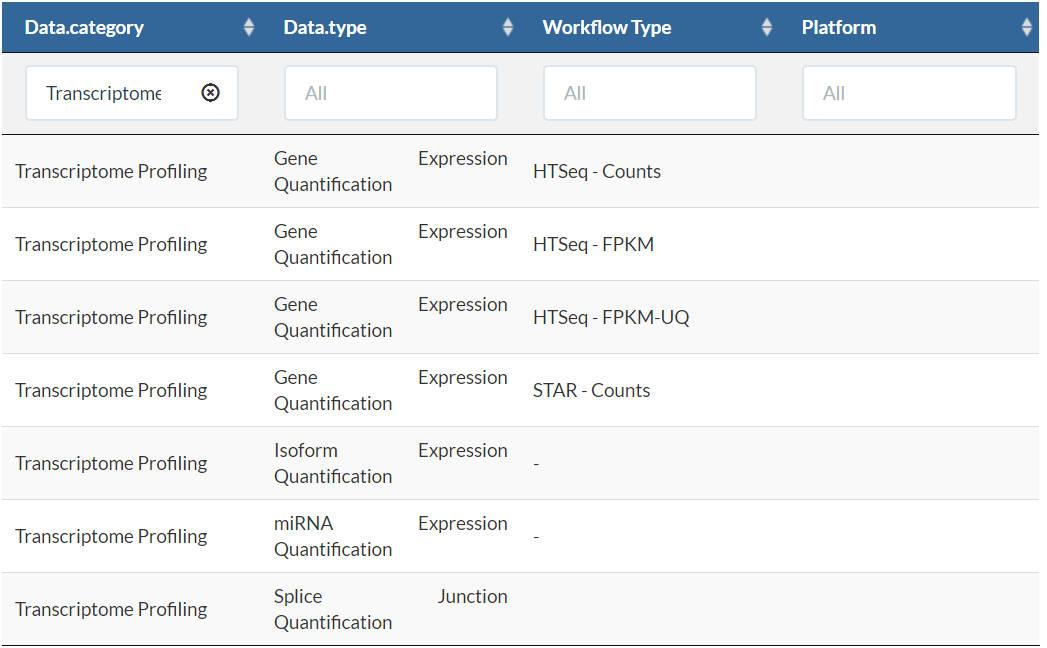
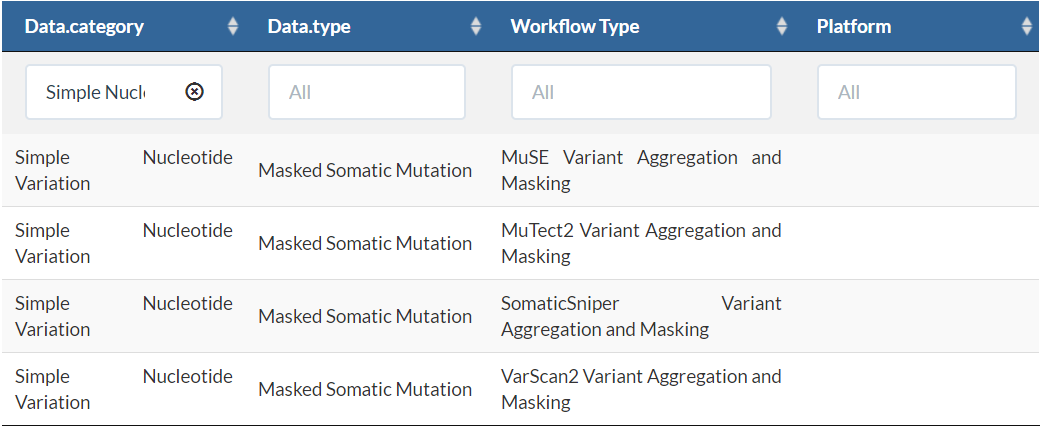
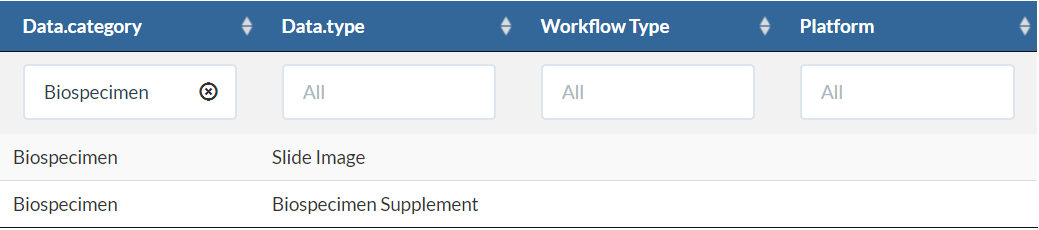
可以使用TCGAbiolinks:::getProjectSummary(project)查看project中有哪些数据类型,如查询"TCGA-COAD",有7种数据类型,case_count为病人数,file_count为对应的文件数。要下载表达谱,可以设置data.category="Transcriptome Profiling"。
> TCGAbiolinks:::getProjectSummary("TCGA-COAD")
$file_count
[1] 15338

$data_categories
  file_count case_count               data_category
1       2000        460            Sequencing Reads
2        531        461                    Clinical
3       2971        460       Copy Number Variation
4       2835        461                 Biospecimen
5        556        458             DNA Methylation
6       2493        459     Transcriptome Profiling
7       3952        433 Simple Nucleotide Variation

$case_count
[1] 461

$file_size
[1] 2.747226e+13
(3)data.type
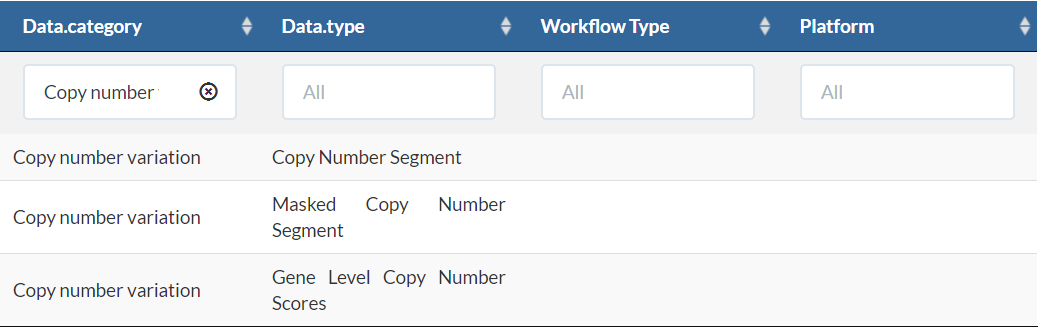
筛选要下载的文件的数据类型。没有命令可以查看data.type里都有哪些数据类型, 但是根据官网连接,查看data.type有12种,但设置参数的时候不代表所有的project和data.category都对应12种。先在官网查看后再设置。
#下载rna-seq的counts数据
data.type = "Gene Expression Quantification"
#下载miRNA数据
data.type = "miRNA Expression Quantification"
#下载Copy Number Variation数据
data.type = "Copy Number Segment"
(4)workflow.type
该数据类型有很多种,根据data.type的不同而不同,不同的数据类型,有其对应的参数可供选择。比如Gene Expression Quantification数据类型下workflow.type 有4种类型分别为:
- HTSeq - FPKM-UQ:FPKM上四分位数标准化值
- HTSeq - FPKM:FPKM值/表达量值
- HTSeq - Counts:原始count数
- STAR - Counts
具体可在GDC官网查看
(5)legacy
这个参数主要是因为TCGA数据有两个入口可以下载,GDC Legacy Archive 和 GDC Data Portal,区别主要是注释参考基因组版本不同分别是:GDC Legacy Archive(hg19和GDC Data Portal(hg38)。参数默认为FALSE,下载GDC Data Portal(hg38)。
(6)access
数据开放和不开放,有两个参数:controlled, open。
(7)platform
这里涉及到的平台种类非常多,可以具体去官网看每种数据都有什么平台的可以下载。这个参数可以省略不设置。
(8)file.type
主要是在GDC Legacy Archive下载数据的时候使用,可以参考官网说明。在GDC Data Portal下载数据,该参数省略不设置。
(9)barcode
TCGA条形码由一组标识符组成。每个都明确地标识一个TCGA数据元素。有关元数据标识符如何组成条形码的说明,分隔符条码包含最多的标识符。
- Aliquot barcode: TCGA-G4-6317-02A-11D-2064-05
- Participant: TCGA-G4-6317
- Sample: TCGA-G4-6317-02
具体可以查看:https://docs.gdc.cancer.gov/Encyclopedia/pages/TCGA_Barcode/
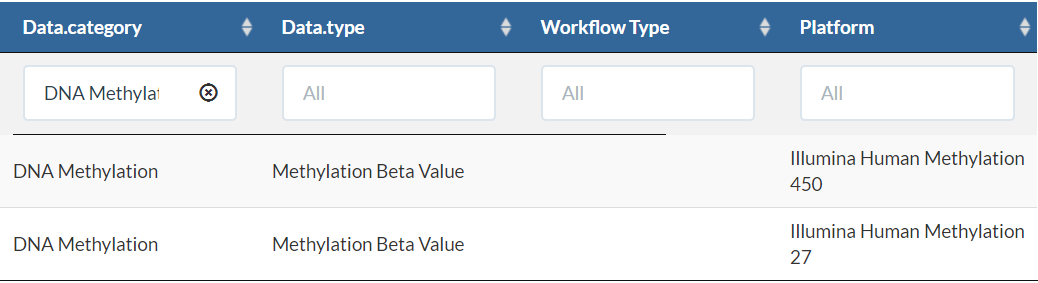
案例:
library(TCGAbiolinks)
query_COAD_EXP <- GDCquery(project = "TCGA-COAD",
                  data.category = "Transcriptome Profiling",
                  data.type = "Gene Expression Quantification",
                  workflow.type = "HTSeq - Counts")query_COAD <- GDCquery(project = "TCGA-COAD",
                  data.category = "Transcriptome Profiling",
                  data.type = "Gene Expression Quantification",
                  workflow.type = "HTSeq - Counts")
2.getResults()函数
该函数从GDCquery函数查询的结果中获取结果表,它可以使用cols参数选择列,并使用rows参数返回若干行。
- query A object from GDCquery
- rows Rows identifiers (row numbers)
- cols Columns identifiers (col names)
GDCquery函数请求的结果是一个数据框。

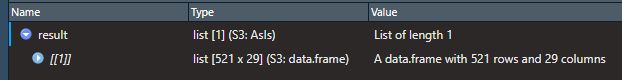
除了results列,其他列都是GDCquery函数设置的参数,results列使我们请求的结果,该列是一个AsIs对象。
取值出来看,类似于长度为1的列表:
取值出来后就是一个数据框。
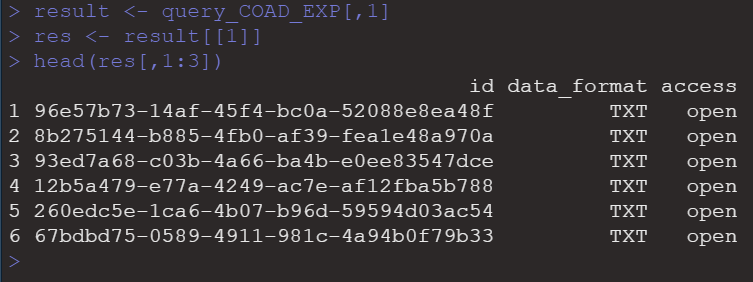
getResults()函数就是从这个数据框中取值。
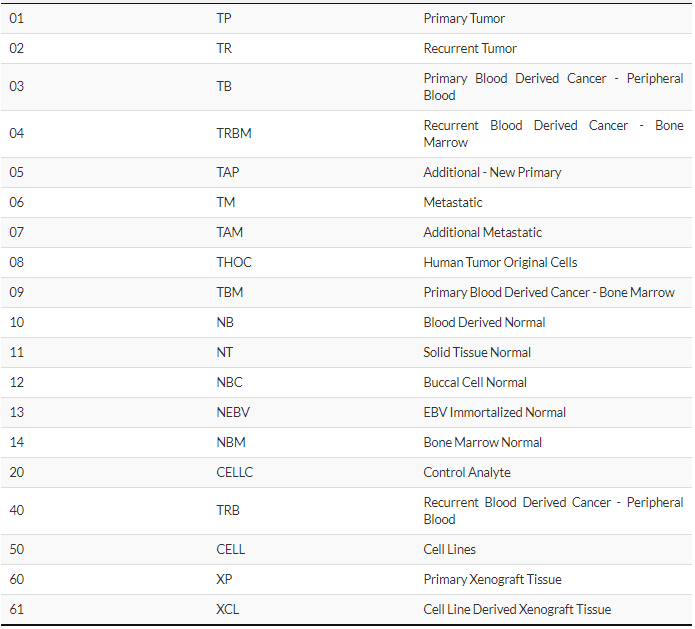
3.TCGAquery_SampleTypes()函数
该函数,就是给barcode,区别样本类型,根据GDC数据库对barcode编号规则来区别的。
# sampCases中筛选出TP(  PRIMARY SOLID TUMOR)样本的cases
dataSmTP <- TCGAquery_SampleTypes(barcode = sampCases,
                                  typesample = "TP")
# sampCases中筛选出NT(Solid Tissue Normal)样本的cases
dataSmNT <- TCGAquery_SampleTypes(barcode = sampCases,
                                  typesample = "NT")
组织样本类型如下:
4.GDCdownload()函数
有两种方法可以使用TCGAbiolinks下载GDC数据。
client:这种方法创建一个MANIFEST文件,并使用GDC数据传输工具下载数据。这种方法更可靠,但它可能比api方法慢。
api:该方法使用GDC API (Application Programming Interface)下载数据。这将创建一个MANIFEST文件,下载的数据将被压缩到tar.gz文件中。如果文件的大小和数量太大,这个tar.gz将太大,这可能有很高的概率下载失败。为了解决这个问题,我们创建了files.per.chunk参数,该参数将文件分成小块,例如,如果files.per.chunk=10,我们将在每个tar.gz中只下载10个文件。
(1)query
由GDCquery()函数生成的对象。
(2)token.file
用于下载受控数据的令牌文件(仅适用于method = " client ")
(3)method
使用API或GDC client工具。选择"api","client"。API更快,但是数据可能会在下载过程中损坏。
(4)directory
下载数据的目录/文件夹。默认值:GDCdata
(5)files.per.chunk
这将使API方法一次只下载n个(files.per.chunk)文件。当数据大小太大时,这个参数将设置每个tar.gz中只下载的文件个数,每个这可能会减少下载可能出现的问题。
下面是下载前面请求的数据案例
下载的转录组数据会在下面路径下,不同类型的数据文件夹命名不一样。
5.GDCprepare()函数
GDCprepare(
  query,
  save = FALSE,
  save.filename,
  directory = "GDCdata",
  summarizedExperiment = TRUE,
  remove.files.prepared = FALSE,
  add.gistic2.mut = NULL,
  mut.pipeline = "mutect2",
  mutant_variant_classification = c("Frame_Shift_Del", "Frame_Shift_Ins",
    "Missense_Mutation", "Nonsense_Mutation", "Splice_Site", "In_Frame_Del",
    "In_Frame_Ins", "Translation_Start_Site", "Nonstop_Mutation")
)
(1)query
由GDCquery()函数生成的对象。
(2)save
保存结果为RData对象?
(3)save.filename
要保存的文件的名称,如果为空,将自动创建。
(4)remove.files.prepared
删除读取的文件?默认值:FALSE仅当save参数设置为true时,该参数才会被考虑。
(5)add.gistic2.mut
If a list of genes (gene symbol) is given, columns with gistic2 results from GDAC firehose (hg19) and a column indicating if there is or not mutation in that gene (hg38) (TRUE or FALSE - use the MAF file for more information) will be added to the sample matrix in the summarized Experiment object.
(6)mut.pipeline
If add.gistic2.mut is not NULL this field will be taken in consideration. Four separate variant calling pipelines are implemented for GDC data harmonization. Options: muse, varscan2, somaticsniper, MuTect2. For more information: https://gdc-docs.nci.nih.gov/Data/Bioinformatics_Pipelines/DNA_Seq_Variant_Calling_Pipeline/
(7)mutant_variant_classification
List of mutant_variant_classification that will be consider a sample mutant or not. Default: “Frame_Shift_Del”, “Frame_Shift_Ins”, “Missense_Mutation”, “Nonsense_Mutation”, “Splice_Site”, “In_Frame_Del”, “In_Frame_Ins”, “Translation_Start_Site”, “Nonstop_Mutation”
下面是准备下面下载的数据案例:
coadRda <- GDCprepare(query_COAD_EXP,save = TRUE,
                      save.filename = "COAD_RNASeq_Counts.rda",
                      summarizedExperiment = TRUE)
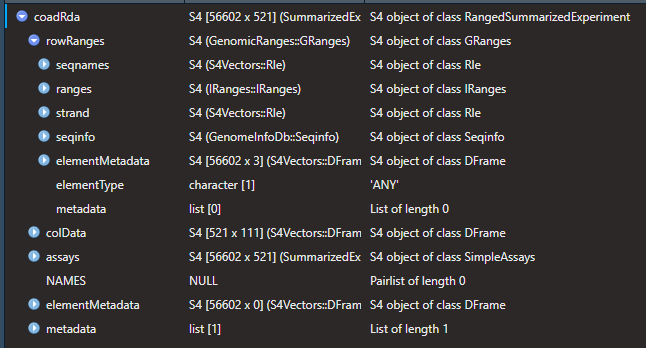
GDCprepare函数,处理转录组的数据,得到的就是一个SummarizedExperiment对象。该对象的主体内容如下:
6.TCGAanalyze_Preprocessing函数()
TCGAanalyze_Preprocessing执行Array Array Intensity correlation (AAIC)。它定义了一个方对称的样本间spearman相关性矩阵。根据相关样本的矩阵和箱线图,有可能找到低相关的样本,可识别为可能的异常值。
TCGAanalyze_Preprocessing(
  object,
  cor.cut = 0,
  filename = NULL,
  width = 1000,
  height = 1000,
  datatype = names(assays(object))[1]
)
(1)object
TCGAprepare函数处理得到的RangedSummarizedExperiment对象
(2)cor.cut
是根据样本之间的spearman相关性对样本进行过滤的阈值,默认 cor.cut= 0。
(3)filename ,width,height
图片文件的文件名,默认NULL,width和height指定图片的宽和高
(4)datatype
一个来自RangedSummarizedExperiment assay的字符串。
expDataPrep <- TCGAanalyze_Preprocessing(object = coadRda,
                                      cor.cut = 0.6,
                                      datatype = "HTSeq - Counts")
head(expDataPrep)[,1:2]
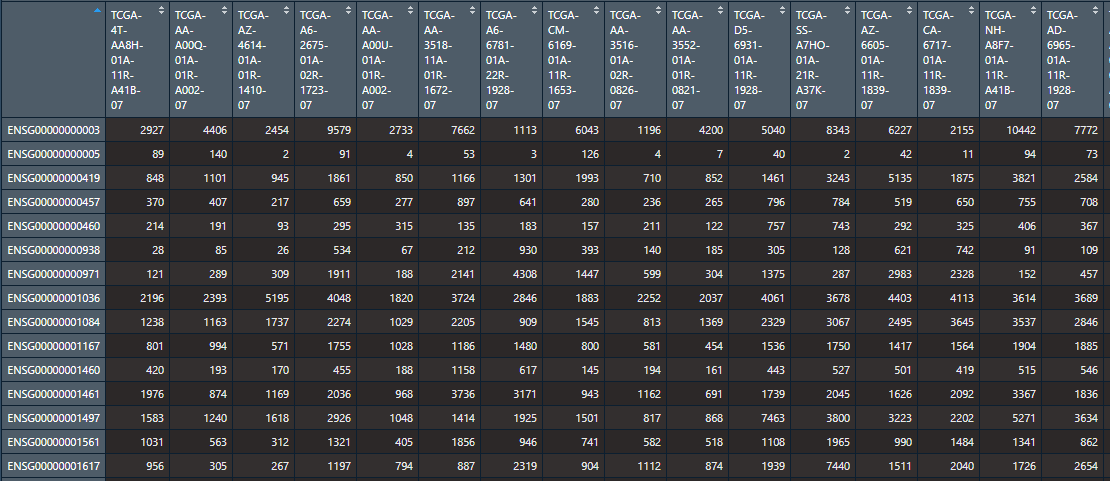
这样得到的就是我们的表达矩阵。就可以用于我们后续的分析啦!
7.TCGAtumor_purity()函数
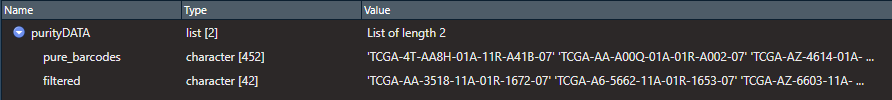
该函数利用5中方法过滤肿瘤纯度,给的值是一个barcodes向量。返回值是一个list,有2个值,一个是纯度搞的barcodes,一个是被过滤的纯度降低的barcodes。也就是说filtered 为被过滤的数据, pure_barcodes是我们要的数据。
# 5种方法过滤肿瘤纯度,这5个值是estimate, absolute, lump, ihc, cpe,这里设置cpe=0.6
purityDATA <- TCGAtumor_purity(colnames(expDataPrep), 0, 0, 0, 0, 0.6)
Purity.barcodes <- purityDATA$pure_barcodes
8.TCGA_MolecularSubtype()
二.数据分析
1.转录组数据分析
library(TCGAbiolinks)
#下载转录组数据
query_COAD_EXP <- GDCquery(project = "TCGA-COAD",
                  data.category = "Transcriptome Profiling",
                  data.type = "Gene Expression Quantification",
                  workflow.type = "HTSeq - Counts")

GDCdownload(query = query_COAD_EXP)
coadRda <- GDCprepare(query_COAD_EXP,save = TRUE,
                      save.filename = "COAD_RNASeq_Counts.rda",
                      summarizedExperiment = TRUE)

expDataPrep <- TCGAanalyze_Preprocessing(object = coadRda,
                                         cor.cut = 0.6,
                                         datatype = "HTSeq - Counts")
TCGAtumor_purity使用5种方法的5种估计作为阈值对TCGA样品进行过滤
sampCases <- getResults(query_COAD_EXP,cols=c("cases"))
# sampCases中筛选出TP(  PRIMARY SOLID TUMOR)样本的cases
dataSmTP <- TCGAquery_SampleTypes(barcode = sampCases,
                                  typesample = "TP")
# sampCases中筛选出NT(Solid Tissue Normal)样本的cases
dataSmNT <- TCGAquery_SampleTypes(barcode = sampCases,
                                  typesample = "NT")
2.下载甲基化数据
#下载甲基化数据
query_COAD_met <- GDCquery(project = "TCGA-COAD",
                      data.category = "DNA Methylation",
                      legacy = FALSE,
                      platform = c("Illumina Human Methylation 450"))

GDCdownload(query_COAD_met)
COAD_met <- GDCprepare(query_COAD_met)
更新: 2022-08-08 11:27:40 原文: https://www.yuque.com/doublehelix/bioinfonotes/lhc0ro